Mô phỏng Monte Carlo là gì? Cách làm, ví dụ và hạn chế
Mô phỏng Monte Carlo (Monte Carlo simulation) là phương pháp sinh ra rất nhiều kịch bản ngẫu nhiên từ một mô hình xác suất, tính kết quả trong từng kịch bản, rồi dùng tập kết quả đó để ước lượng giá trị kỳ vọng, phân vị hoặc xác suất của một sự kiện. Trong tài chính, phương pháp này được dùng để định giá quyền chọn, đo rủi ro danh mục và lập kế hoạch đầu tư dài hạn. Người dùng kết quả cần hiểu rằng mô phỏng chỉ tính đúng những gì mô hình giả định, và con số thu được luôn có sai số do số kịch bản có hạn.
1. Mô phỏng Monte Carlo là gì?
Mô phỏng Monte Carlo là cách ước lượng một đại lượng bằng trung bình của rất nhiều lần rút ngẫu nhiên từ một phân phối đã giả định, thay vì giải bằng công thức. Phương pháp này hữu ích khi bài toán có nhiều nguồn bất định, kết quả phụ thuộc vào cả đường đi của giá, hoặc không có lời giải đóng.
Gọi là biến ngẫu nhiên đầu vào (ví dụ lợi suất các năm) và là kết quả quan tâm (ví dụ giá trị danh mục sau 10 năm). Với kịch bản độc lập , ước lượng Monte Carlo của là:
Trong đó là độ lệch chuẩn của trên các kịch bản và SE là sai số chuẩn của ước lượng. Theo luật số lớn, tiến về giá trị đúng khi tăng. Xác suất cũng là một kỳ vọng: xác suất lỗ bằng trung bình của biến nhận giá trị 1 khi lỗ và 0 khi không lỗ, nên cũng ước lượng được theo cùng cách.
Cần phân biệt mô phỏng Monte Carlo với phân tích kịch bản thông thường. Phân tích kịch bản chọn vài trường hợp rời rạc (tốt, cơ sở, xấu), và nếu có gán xác suất thì đó là ước tính chủ quan của người phân tích cho từng trường hợp; Monte Carlo sinh hàng nghìn trường hợp theo một phân phối nên cho biết mỗi vùng kết quả có khả năng xảy ra bao nhiêu, với điều kiện phân phối đó đúng.
2. Nguồn gốc tên gọi Monte Carlo
Phương pháp Monte Carlo ra đời tại Phòng thí nghiệm Los Alamos (Mỹ) ngay sau Thế chiến II. Theo hồi ký của Nicholas Metropolis đăng trên Los Alamos Science năm 1987, sau buổi đánh giá kết quả tính toán trên máy ENIAC vào mùa xuân năm 1946, nhà toán học Stanislaw Ulam đề xuất dùng lại kỹ thuật lấy mẫu thống kê vốn bị bỏ vì quá tốn công tính tay. John von Neumann thấy ý tưởng khả thi và ngày 11/3/1947 gửi thư phác thảo cách dùng nó cho bài toán khuếch tán neutron.
Tên gọi do Metropolis đề xuất, gắn với sòng bạc Monte Carlo ở Monaco: Ulam có một người chú hay vay tiền họ hàng vì "phải đi Monte Carlo". Phương pháp được công bố rộng rãi qua bài báo "The Monte Carlo Method" của Metropolis và Ulam (1949) trên Journal of the American Statistical Association. Metropolis cũng ghi lại rằng Enrico Fermi đã dùng cách lấy mẫu tương tự ở Rome từ đầu thập niên 1930 nhưng không công bố.
Lưu ý: Một số bài viết nói Monte Carlo được phát triển trong Thế chiến II. Theo Metropolis, ý tưởng của Ulam xuất hiện sau buổi đánh giá mùa xuân năm 1946, tức sau khi chiến tranh kết thúc, và thư của von Neumann đề ngày 11/3/1947. Phương pháp ra đời từ cùng phòng thí nghiệm và nhóm nhà khoa học của Dự án Manhattan, nhưng không phải là công cụ dùng trong thời chiến.
Trong tài chính, bài báo của Phelim Boyle (1977) trên Journal of Financial Economics thường được dẫn là công trình đầu tiên dùng mô phỏng Monte Carlo để định giá quyền chọn.
3. Cách thực hiện mô phỏng Monte Carlo
3.1. Các bước chung
Mọi mô phỏng Monte Carlo đều gồm năm bước, dù bài toán đơn giản hay phức tạp:
- Xác định đại lượng cần ước lượng, ví dụ xác suất danh mục lỗ sau 10 năm.
- Chọn mô hình cho các biến ngẫu nhiên: phân phối, tham số, quan hệ giữa các kỳ và giữa các tài sản.
- Sinh một kịch bản: rút số ngẫu nhiên theo mô hình và tính kết quả.
- Lặp lại bước 3 hàng nghìn lần, lưu kết quả của từng kịch bản.
- Tổng hợp: tính trung bình, phân vị, tỷ lệ kịch bản thỏa điều kiện, kèm sai số chuẩn.
3.2. Ví dụ với Danh mục UQ
Danh mục UQ (giả định) có giá trị ban đầu 1.000 triệu đồng và được giữ 10 năm, không nộp thêm, không rút ra. Giả định lợi suất log mỗi năm có phân phối chuẩn với trung bình , độ lệch chuẩn (volatility) , độc lập giữa các năm. Giá trị cuối năm được tính theo lãi kép liên tục:
Bảng sau là ba năm đầu của kịch bản số 1 trong lần chạy 10.000 kịch bản (Python 3, numpy 2.4.4, seed 138).
| Năm | Lợi suất log rút ngẫu nhiên | Phép tính | Giá trị cuối năm (triệu đồng) |
|---|---|---|---|
| 0 | 1.000,0 | ||
| 1 | −26,43% | 767,8 | |
| 2 | −5,81% | 724,5 | |
| 3 | −20,32% | 591,3 |
Kịch bản này kết thúc năm 10 ở 495,5 triệu đồng. Kịch bản số 2 kết thúc ở 2.133,8 triệu đồng, kịch bản số 4 ở 3.914,0 triệu đồng. Từng kịch bản riêng lẻ không có ý nghĩa; thông tin nằm ở phân phối của cả 10.000 kết quả.
| Kết quả sau 10 năm | Mô phỏng 10.000 kịch bản | Tính bằng công thức |
|---|---|---|
| Giá trị trung bình (triệu đồng) | 2.472,8 | 2.459,6 |
| Trung vị (triệu đồng) | 2.004,8 | 2.013,8 |
| Phân vị 5% (triệu đồng) | 720,7 | 711,6 |
| Phân vị 95% (triệu đồng) | 5.792,1 | 5.699,0 |
| Xác suất giá trị dưới 1.000 triệu đồng | 13,16% | 13,42% |
| Xác suất giá trị dưới 500 triệu đồng | 1,28% | 1,38% |
Bài toán này cố ý chọn đủ đơn giản để có lời giải đóng: tổng 10 lợi suất log có phân phối chuẩn với trung bình và độ lệch chuẩn . Khi đó trung vị là , trung bình là , và xác suất lỗ là , với là hàm phân phối tích lũy của phân phối chuẩn tắc. Kết quả mô phỏng lệch khỏi giá trị đúng một khoảng nhỏ, đúng như sai số chuẩn dự báo (mục 5). Với bài toán thực tế không có công thức, nhất là khi có nhiều biến ngẫu nhiên, mô phỏng thường là cách thực tế nhất để có các con số này.
3.3. Cách làm trên Excel
Có thể dựng lại ví dụ trên bằng Excel mà không cần lập trình:
- Ô B2 đến K2 (10 năm): nhập
=NORM.INV(RAND(), 7%, 20%). HàmRAND()trả về số ngẫu nhiên đều trong khoảng 0 đến 1, hàmNORM.INVđổi nó thành lợi suất có phân phối chuẩn. - Ô L2: nhập
=1000*EXP(SUM(B2:K2)), là giá trị danh mục năm 10. - Sao chép dòng 2 xuống 10.000 dòng.
- Tổng hợp bằng
AVERAGE,MEDIAN,PERCENTILE.INCtrên cột L, và xác suất lỗ bằng=COUNTIF(L2:L10001, "<1000")/10000.
Hàm RAND() tính lại mỗi khi bảng tính thay đổi, nên kết quả nhảy liên tục. Để giữ cố định một lần chạy, sao chép cột kết quả và dán dạng giá trị; trong Python, việc này tương ứng với cố định seed. Excel phiên bản cài đặt tiếng Việt có thể dùng dấu chấm phẩy thay dấu phẩy để ngăn cách đối số.
4. Cách đọc kết quả mô phỏng
Kết quả mô phỏng nên đọc như một phân phối, không phải một con số dự báo. Ba chỉ tiêu thường dùng là trung bình, các phân vị và xác suất của sự kiện cần quan tâm.
Với Danh mục UQ, giá trị trung bình 2.472,8 triệu đồng cao hơn trung vị 2.004,8 triệu đồng, và 62,1% số kịch bản kết thúc dưới mức trung bình. Nguyên nhân là phân phối giá trị cuối kỳ lệch phải: một số ít kịch bản tăng rất mạnh (cao nhất 25.433,3 triệu đồng) kéo trung bình lên, trong khi giá trị không thể xuống dưới 0. Nếu trình bày con số trung bình như "kết quả dự kiến", người đọc sẽ hiểu sai về kịch bản điển hình.
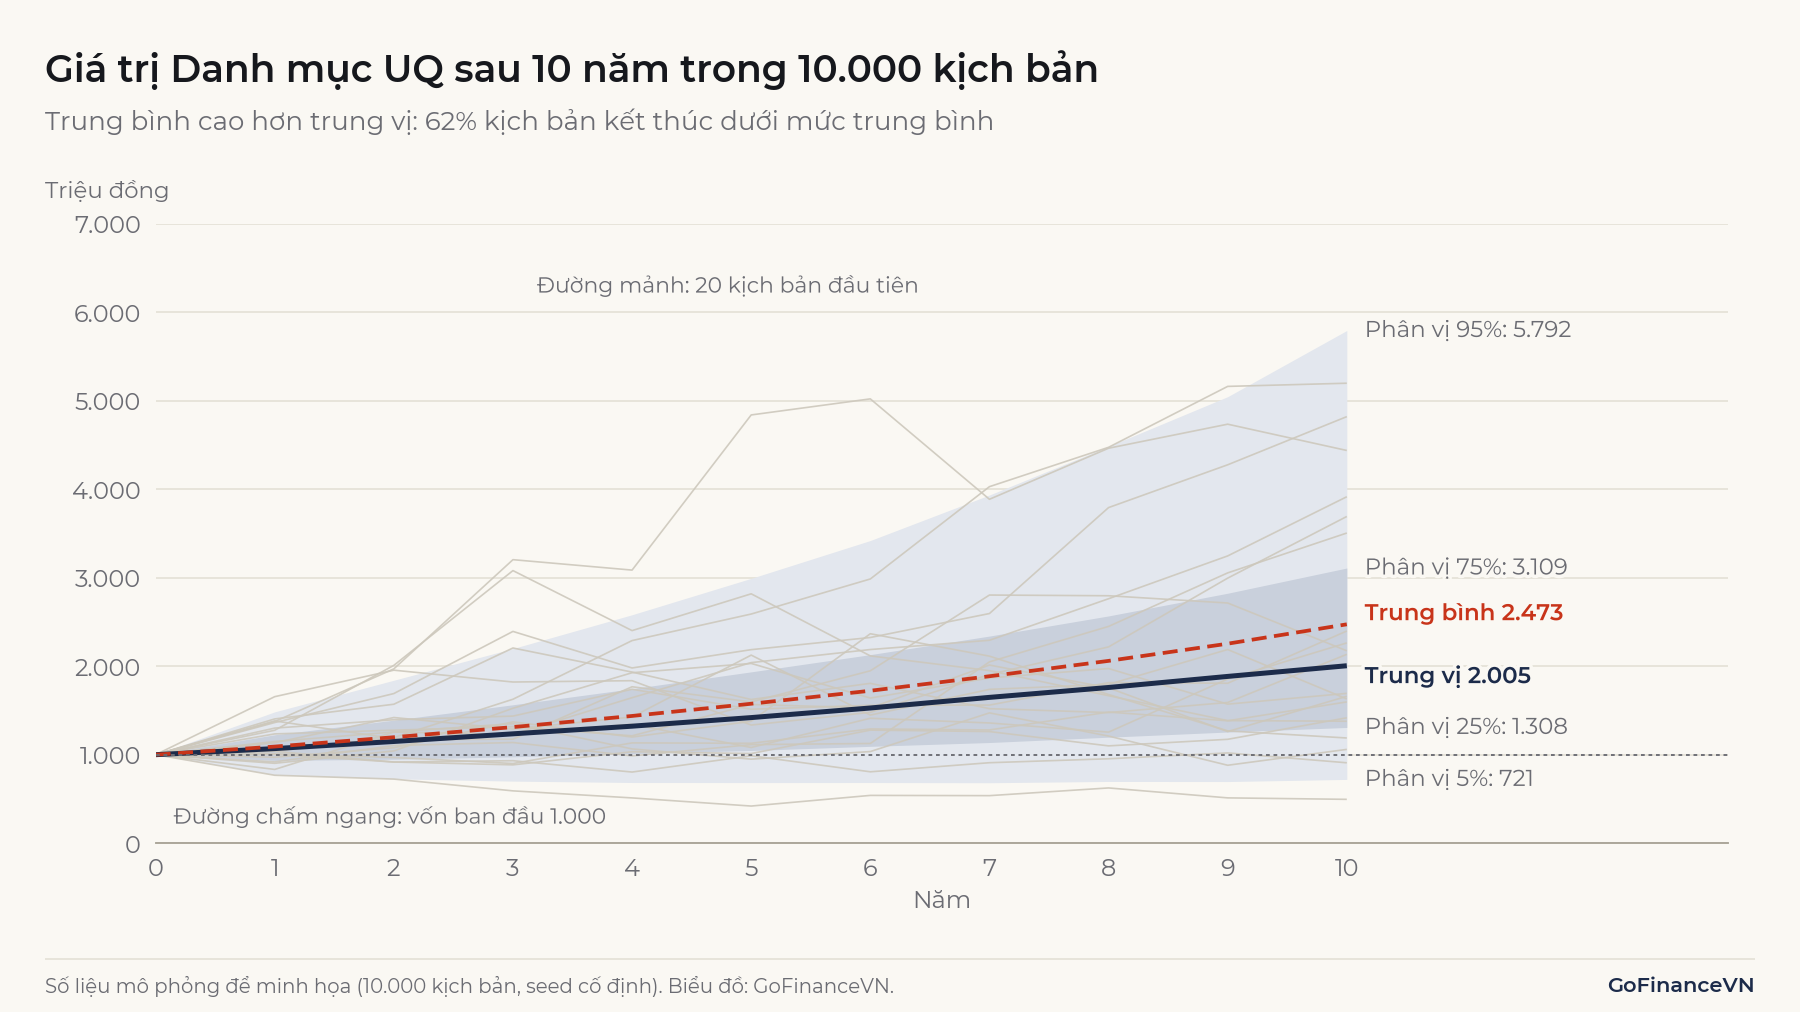
Phân vị cho biết độ rộng của kết quả: 5% số kịch bản có giá trị năm 10 dưới 720,7 triệu đồng và 5% có giá trị trên 5.792,1 triệu đồng. Mô phỏng còn trả lời được những câu hỏi phụ thuộc đường đi mà công thức đơn giản khó trả lời. Ví dụ, chỉ 13,16% kịch bản kết thúc dưới vốn ban đầu, nhưng 57,06% kịch bản có ít nhất một thời điểm cuối năm nằm dưới vốn ban đầu trong 10 năm.
5. Cần chạy bao nhiêu kịch bản?
Số kịch bản cần chạy phụ thuộc vào độ chính xác mong muốn, vì sai số chuẩn của ước lượng giảm theo . Với xác suất , sai số chuẩn là .
Ví dụ: Với và , sai số chuẩn là điểm phần trăm. Khoảng tin cậy 95% xấp xỉ ±0,67 điểm phần trăm. Muốn thu hẹp khoảng này còn một nửa (±0,33 điểm phần trăm), cần 40.000 kịch bản, tức gấp bốn lần.
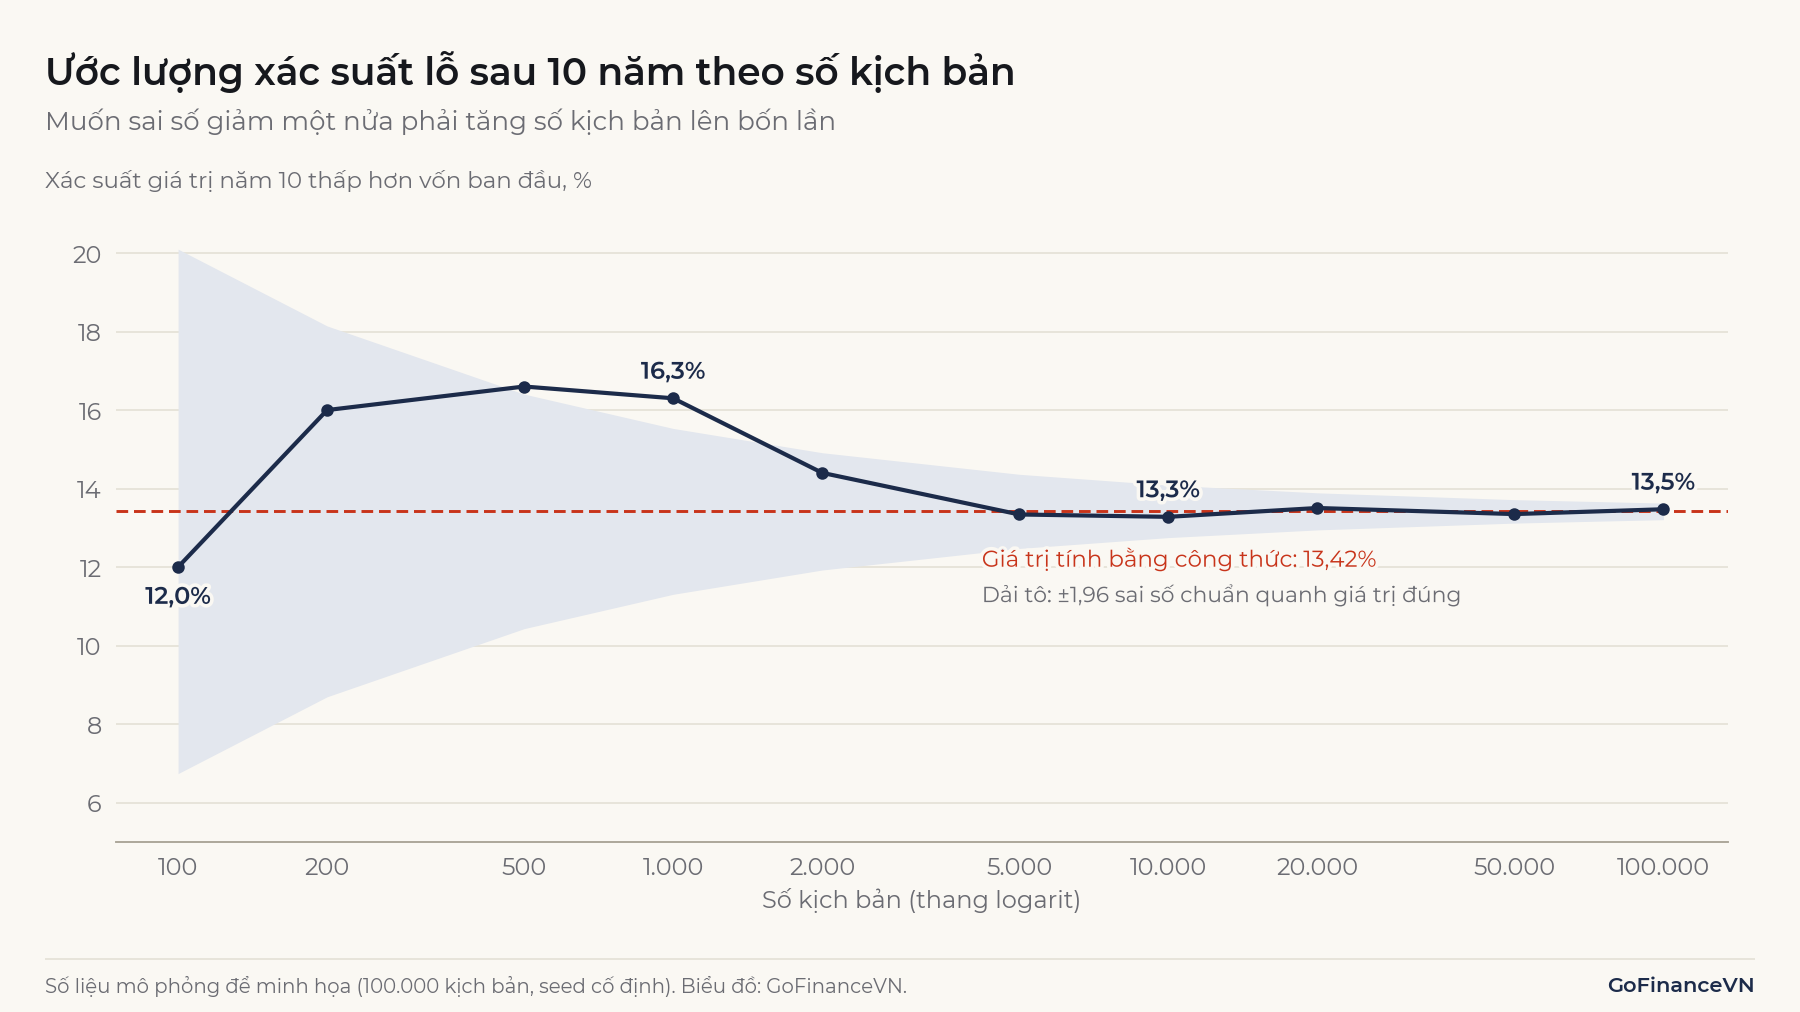
Hình 2 cho thấy với vài trăm đến 1.000 kịch bản, ước lượng có thể lệch khoảng 3 điểm phần trăm (16,6% ở 500 kịch bản và 16,3% ở 1.000 kịch bản, so với 13,42%). Hai điểm này nằm ngoài dải ±1,96 sai số chuẩn: các điểm trên hình là tích lũy trên cùng một chuỗi kịch bản nên không độc lập với nhau, và cứ khoảng 20 lần ước lượng thì đã có một lần nằm ngoài dải dù không có gì sai. Từ khoảng 5.000 kịch bản trở lên, ước lượng nằm sát giá trị đúng. Vì tốc độ hội tụ chậm, người làm mô hình thường dùng kỹ thuật giảm phương sai (variance reduction) thay vì chỉ tăng số kịch bản. Giáo trình Monte Carlo trong tài chính của Glasserman (2003) dành riêng chương 4 (Variance Reduction Techniques) cho các kỹ thuật này.
Sai số chuẩn chỉ đo sai số do lấy mẫu. Nó không đo sai số do chọn sai mô hình, và sai số này không giảm khi tăng số kịch bản.
6. Ứng dụng của mô phỏng Monte Carlo trong tài chính
Mô phỏng Monte Carlo được dùng khi kết quả phụ thuộc vào nhiều biến ngẫu nhiên hoặc vào đường đi của giá, và khi công thức giải tích không có hoặc quá phức tạp.
- Định giá quyền chọn và sản phẩm phái sinh phụ thuộc đường đi (quyền chọn châu Á tính theo giá bình quân, quyền chọn rào cản), nơi công thức đóng thường không tồn tại.
- Đo rủi ro thị trường: VaR theo phương pháp Monte Carlo sinh kịch bản cho các yếu tố rủi ro, định giá lại danh mục trong từng kịch bản rồi lấy phân vị của lãi lỗ.
- Lập kế hoạch tài chính dài hạn: ước lượng xác suất một danh mục đạt mục tiêu hoặc đủ chi trả trong thời gian nghỉ hưu, khi có dòng tiền nộp và rút.
- Thẩm định dự án và định giá: cho doanh thu, biên lợi nhuận, chi phí đầu tư biến động theo phân phối để có phân phối của NPV thay vì một giá trị duy nhất.
Định giá quyền chọn là trường hợp kiểm tra được bằng công thức. Lấy cùng giả định với ví dụ trong bài quyền chọn: giá tài sản 50.000 đồng, giá thực hiện 52.000 đồng, kỳ hạn 3 tháng, volatility 30%/năm, lãi suất phi rủi ro 4%/năm, không cổ tức. Mô phỏng sinh giá đáo hạn theo với chuẩn tắc, rồi lấy trung bình của chiết khấu về hiện tại bằng . Với 100.000 kịch bản (seed 140), giá ước lượng là 2.333,3 đồng, sai số chuẩn 13,5 đồng, so với 2.349,6 đồng theo công thức Black-Scholes; chênh lệch nằm trong khoảng ±1,96 sai số chuẩn.
Công thức dùng để đối chiếu được giải thích trong bài Black-Scholes là gì?
Điểm cần lưu ý là định giá quyền chọn dùng lãi suất phi rủi ro làm mức tăng kỳ vọng của giá (định giá trung lập rủi ro), khác với ví dụ Danh mục UQ dùng lợi suất kỳ vọng giả định. Hai mục đích khác nhau thì mô hình sinh kịch bản cũng khác nhau.
Monte Carlo ít phù hợp khi bài toán đã có công thức đóng chính xác và nhanh, hoặc khi người dùng không có cơ sở để chọn phân phối đầu vào.
7. Hạn chế và lưu ý khi sử dụng
7.1. Kết quả chỉ đúng bằng mô hình đầu vào
Mô phỏng không tạo thêm thông tin về thị trường; nó chỉ tính hệ quả của giả định. Nếu đổi lợi suất log trung bình của Danh mục UQ từ 7% xuống 5%, xác suất lỗ sau 10 năm theo công thức tăng từ 13,42% lên 21,46%. Sai lệch kiểu này lớn hơn nhiều so với sai số do số kịch bản.
7.2. Giả định phân phối chuẩn và độc lập bỏ sót rủi ro đuôi
Lợi suất thực tế thường có đuôi dày hơn phân phối chuẩn, biến động thay đổi theo thời gian và tương quan giữa các tài sản tăng khi thị trường giảm mạnh. Mô hình trong ví dụ không có các đặc điểm này, nên xác suất các kịch bản cực đoan có thể bị đánh giá thấp. Có thể thay bằng phân phối Student t, mô hình biến động thay đổi (GARCH) hoặc bổ sung kiểm định sức chịu đựng.
Kiểm định sức chịu đựng ở cấp ngân hàng được trình bày trong bài Stress test ngân hàng là gì?.
7.3. Tham số ước lượng từ quá khứ
Trung bình và độ lệch chuẩn đầu vào thường ước lượng từ dữ liệu lịch sử, nên mang theo sai số ước lượng và các sai lệch của dữ liệu như chỉ dùng mã còn niêm yết. Các lỗi này đã được phân tích trong bài backtest và vẫn còn nguyên khi đưa vào mô phỏng.
7.4. Nhầm lợi suất log với lợi suất đơn
Lợi suất log trung bình 7%/năm tương ứng với lợi suất đơn kỳ vọng /năm, không phải 7%. Dùng nhầm một trong hai làm giá trị cuối kỳ lệch đáng kể sau nhiều năm: triệu đồng so với triệu đồng.
7.5. Số ngẫu nhiên là số giả ngẫu nhiên
Máy tính sinh số giả ngẫu nhiên (pseudo-random) từ một giá trị khởi tạo gọi là seed. Cố định seed giúp người khác chạy lại được đúng kết quả. Ngược lại, thử nhiều seed rồi chọn kết quả đẹp nhất là một dạng sai lệch, tương tự việc thử nhiều tham số trong backtest.
8. Câu hỏi thường gặp
Mô phỏng Monte Carlo có dự báo được giá cổ phiếu không?
Không. Monte Carlo cho phân phối các kết quả có thể xảy ra dưới một mô hình giả định, không cho biết kịch bản nào sẽ xảy ra. Mô hình càng sai so với thực tế thì phân phối đó càng sai.
Monte Carlo khác mô phỏng lịch sử và bootstrap thế nào?
Monte Carlo rút kịch bản từ một phân phối do người làm mô hình chọn. Mô phỏng lịch sử áp nguyên các biến động đã xảy ra vào danh mục hiện tại. Bootstrap rút ngẫu nhiên có hoàn lại từ chính dữ liệu quan sát, nên không cần giả định dạng phân phối nhưng chỉ dùng được những giá trị đã có trong mẫu.
Kết luận
Mô phỏng Monte Carlo ước lượng kỳ vọng, phân vị và xác suất bằng cách tính kết quả trên hàng nghìn kịch bản ngẫu nhiên sinh từ một mô hình. Sai số do lấy mẫu giảm theo căn bậc hai của số kịch bản và đo được; sai số do chọn mô hình thì không giảm và không hiện ra trong kết quả. Vì vậy một kết quả Monte Carlo cần đi kèm giả định phân phối, tham số, số kịch bản và seed.
Bài viết mang tính giáo dục, không phải khuyến nghị đầu tư.
Nguồn tham khảo
- Metropolis, N. (1987), The Beginning of the Monte Carlo Method, Los Alamos Science, số 15, tr. 125–130: https://mcnpx.lanl.gov/pdf_files/Article_1987_LAS_Metropolis_125--130.pdf
- Metropolis, N. và Ulam, S. (1949), The Monte Carlo Method, Journal of the American Statistical Association 44(247), 335–341: https://doi.org/10.1080/01621459.1949.10483310
- Boyle, P. (1977), Options: A Monte Carlo Approach, Journal of Financial Economics 4(3), 323–338: https://doi.org/10.1016/0304-405X%2877%2990005-8
- Glasserman, P. (2003), Monte Carlo Methods in Financial Engineering, Springer: https://doi.org/10.1007/978-0-387-21617-1
- CFA Institute, Refresher Reading 2026: Simulation Methods: https://www.cfainstitute.org/insights/professional-learning/refresher-readings/2026/simulation-methods
Đọc tiếp: VaR là gì? Cách tính Value at Risk và những hạn chế